Zarządzanie produktem · 2 min czytania
Ten o czekaniu między zespołami
Opóźnienia między zespołami w value stream: dlaczego lokalnie efektywne zespoły dają klientowi pół roku czekania i po co mierzyć cały przepływ.
Ostatnio siedzę z managerem przy kawie, a on tak do mnie: „Każdy zespół robi swoje, szybko, efektywnie, ale jakoś tematy się ciągną”.
Spojrzałem mu w oczy i powiedziałem: DELAY.
Ten niewidzialny zabójca każdego Value Streamu. Składnik, którego nikt nie planuje, ale który jest wszędzie.
Pamiętam projekt sprzed roku. Zespół A skończył swoją część w poniedziałek rano, dumni jak pawie. Zespół B miał to w backlogu… na pozycji 47. Za 2 miesiące może zaczną się tym zajmować. Zespół C spokojnie siedzi i czeka, aż B skończy.
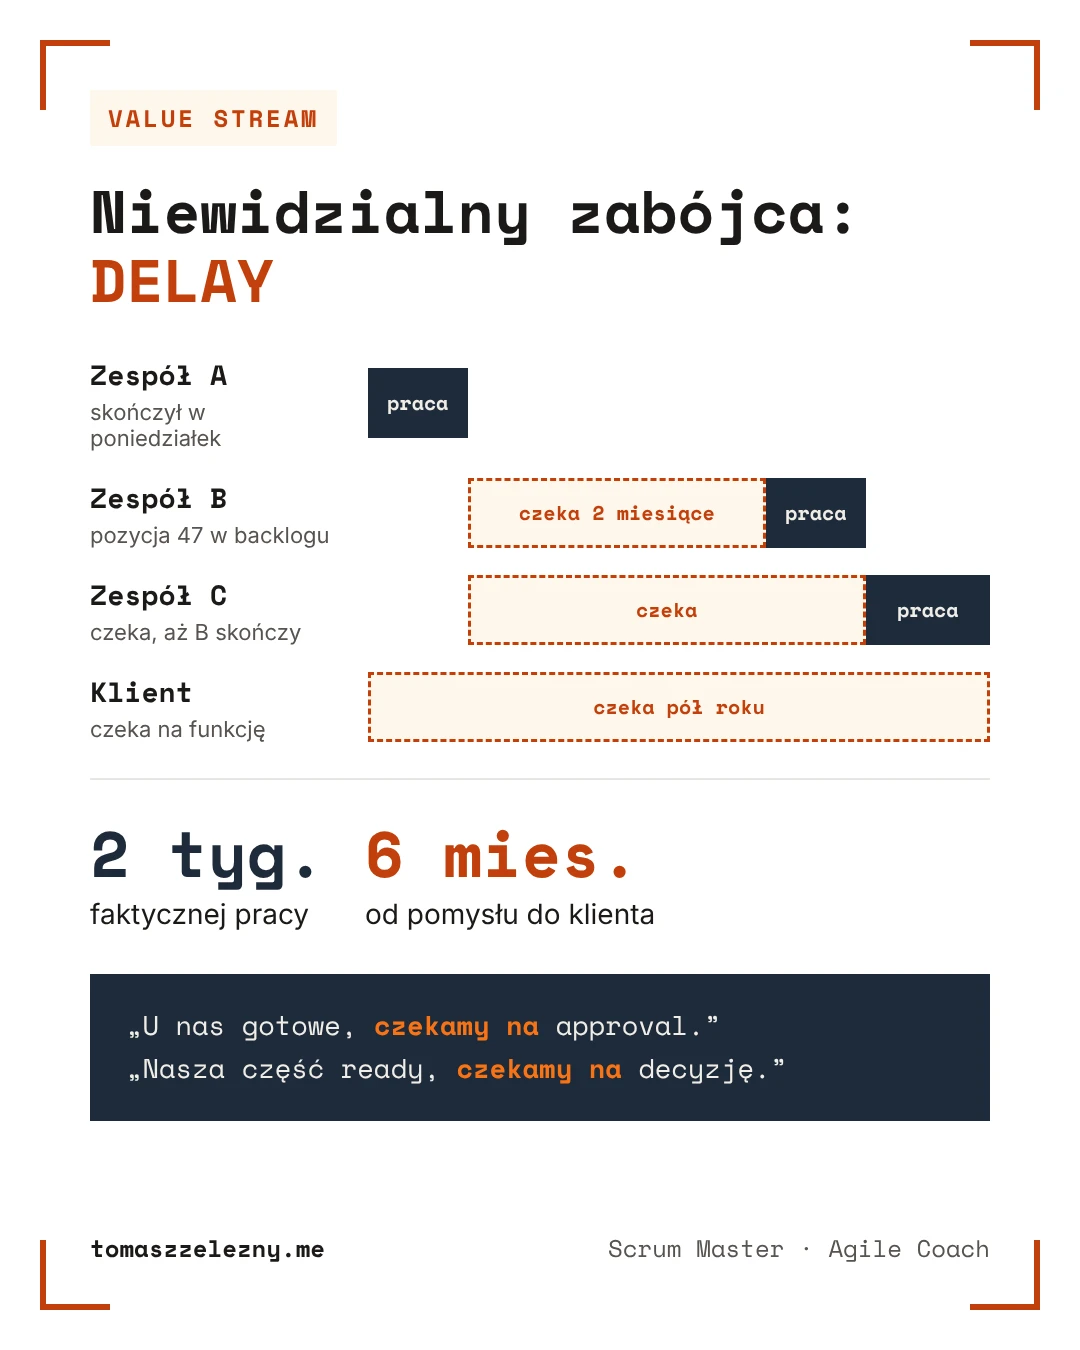
Wiele zespołów robi swoje. Lokalne działania często wyglądają na „efektywne”. A klient? Klient może sobie poczekać pół roku na funkcję, która faktycznie zajęła 2 tygodnie. Dlaczego tak się dzieje, wyjaśnia teoria ograniczeń; pisałem o niej we wpisie o jednym wąskim gardle.
Delay to ten magiczny składnik, który sprawia, że chociaż każdy krok jest efektywny, klient ciągle obchodzi się smakiem. Często mierzymy jedynie lokalną prędkość, a znacznie rzadziej to, jak długo rzeczy po prostu leżą.
„My już skończyliśmy”?
„U nas gotowe, czekamy na approval od managera.”
„Mamy zrobione, czekamy na wolne środowisko testowe.”
„Po naszej stronie koniec, czekamy aż drugi zespół skończy swoją część.”
„Nasza część ready, czekamy na decyzję biznesową.”
Bo właśnie w tym „czekamy na” znika energia i wcześniej poświęcone środki.
Wy czekacie i klient też czeka.
I właśnie dlatego warto mierzyć poziom wyżej: patrzeć na cały Value Stream, a nie tylko na lokalne wyniki.
Jaki najdłuższy delay między zespołami pamiętacie? Ja znam historię o 8 miesiącach oczekiwania na „approval”. A wy? 👇
Jak DevOps usuwa jeden z najstarszych podziałów między zespołami, opisałem we wpisie o płocie między Dev i Ops.
💬 Dołącz do dyskusji na LinkedIn → Komentuj i podziel się swoim podejściem
Tomasz Żelezny
Scrum Master · Agile Coach
Pomagam zespołom robić mniej rzeczy naraz i kończyć więcej. Piszę o przepływie pracy, decyzjach i o tym, gdzie znika wysiłek zespołów.
Twój zespół może więcej niż dowozi.
Zobacz, jak pomagam