Zarządzanie produktem · 7 min czytania
Ten o tablicy tablic
Ukryte kolejki pracy w organizacji przypominają tablicę tablic z C++: widać liczbę zespołów, a nie pracę, która czeka w ich kolejkach. Jak je policzyć.
Kto pisał w C++, zna tablicę tablic, czyli std::vector<std::vector<T>>. Zewnętrzna tablica nie trzyma danych, tylko kolejne tablice, a każda z nich może mieć inną długość. (Zwykła tablica dwuwymiarowa, int t[3][4], ma wszystkie wiersze równe, więc tu chodzi o tę pierwszą.) Na pierwszy rzut oka to zwykła lista z kilkoma pozycjami. Prawdziwa ilość danych siedzi poziom niżej i nie widać jej, dopóki nie zajrzysz do środka.
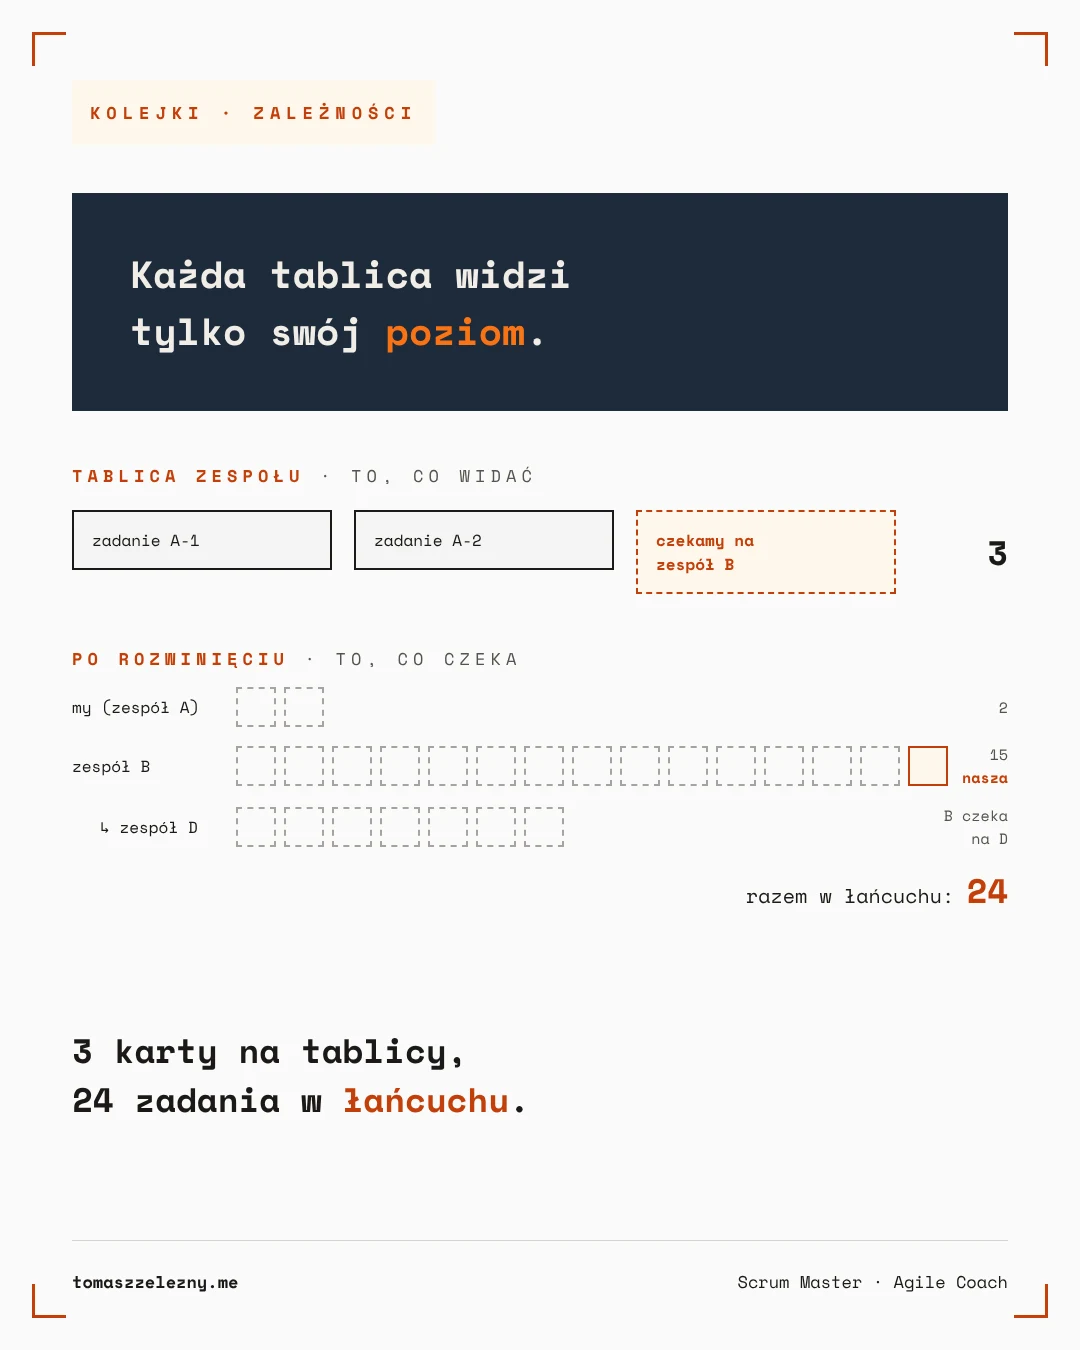
Tak samo wygląda praca w wielu organizacjach. Na tablicy zespołu jest jedno zadanie „czekamy na zespół płatności”. W środku tego zadania jest cała kolejka innego zespołu, a w niej kolejne zadania, które czekają na jeszcze inny zespół.
Co pokazuje tablica tablic?
Pokazuje liczbę kolejek, a nie liczbę elementów. Weźmy taki kod:
std::vector<std::vector<Element>> praca = {
    {a, b},           // zespół A
    {c, d, e, f, g},  // zespół B
    {h}               // zespół C
};

praca.size();  // 3
praca.size() zwraca 3, bo tyle jest wewnętrznych tablic. Elementów jest osiem. Żeby się tego dowiedzieć, trzeba przejść pętlą po każdej wewnętrznej tablicy i zsumować ich rozmiary. Nikt tego nie robi przy każdym spojrzeniu, więc w głowie zostaje liczba 3.
W C jest jeszcze gorzej: tablica tablic to tablica wskaźników, a wskaźnik nie wie, ile elementów jest pod nim.
Element *praca[] = {zespol_a, zespol_b, zespol_c};
Element praca[1] to tylko adres miejsca w pamięci, gdzie zaczynają się elementy zespołu B. Długości wewnętrznych tablic trzeba pamiętać osobno, a jeśli nikt ich nie zapisał, nie da się ich odczytać. Na tablicy zespołu zadanie „czekamy na zespół B” działa tak samo: mówi, gdzie jest praca, ale nie mówi, ile jej tam jest ani jak długo potrwa.
Gdzie w organizacji chowają się kolejki?
Chowają się wszędzie tam, gdzie jeden zespół potrzebuje czegoś od drugiego. Zgłoszenie do zespołu infrastruktury, prośba o zmianę w API, akceptacja od działu prawnego, przegląd bezpieczeństwa. Każda z tych rzeczy trafia do cudzego backlogu i tam czeka na swoją kolej.
Na naszej tablicy widać jedną kartę w kolumnie „Zablokowane”. Nie widać, że przed nami w kolejce zespołu B jest czternaście innych próśb, więc nasza jest piętnasta. Nie widać też, że zespół B sam czeka na zespół D, więc nasza prośba stoi w kolejce, która stoi w kolejce. To jest zagnieżdżenie drugiego stopnia, a w dużej firmie bywa ich więcej.
Każdy zespół widzi swój poziom. Nikt nie widzi całej struktury, bo nikt nie przechodzi po wszystkich tablicach naraz. Podobnie było z rozmowami, które trzeba odbyć przy zmianie przekrojowej: złożoność organizacji wycieka na zewnątrz, ale nie trafia na żadną tablicę.
Dlaczego ukryta kolejka wydłuża czas dostarczenia?
Bo czas dostarczenia zależy od tego, ile pracy czeka w systemie, a nie od tego, ile pracy widzimy. Prawo Little’a mówi, że w stabilnym systemie średni czas przejścia zadania to średnia ilość pracy w toku podzielona przez średnią przepustowość. Działa to też dla każdej kolejki z osobna. Jeśli w kolejce zespołu B czeka piętnaście próśb, a zespół B zamyka pięć tygodniowo, nasza prośba poczeka tam średnio około trzech tygodni. Na naszej tablicy to wciąż jedna karta, więc prognoza liczona tylko z naszej tablicy wychodzi zbyt optymistyczna.
Stąd biorą się zadania, które idą trzy tygodnie, choć praca nad nimi trwa kilka godzin. Przez większość czasu zadanie po prostu czeka, i to często nie u nas, tylko w czyjejś kolejce. Modig i Åhlström nazywają to niską efektywnością przepływu: liczy się, jaką część czasu zadanie jest naprawdę obrabiane, a nie jak zajęci są ludzie. Donald Reinertsen pisze, że kolejki w rozwoju produktu są niewidoczne, bo w przeciwieństwie do magazynu w fabryce nie zajmują miejsca. Nikt nie potyka się o stos niezałatwionych zgłoszeń.
Do tego każdy zespół w łańcuchu może być w pełni zajęty. Wszyscy pracują, wszyscy mają pełne sprinty, a zadanie i tak stoi. To ta sama pułapka co zajętość, która udaje postęp. Reinertsen pokazuje, że przy obciążeniu bliskim 100% kolejki rosną gwałtownie, a nie liniowo. Im bardziej zajęci są wszyscy, tym dłużej czeka praca.
Jak spłaszczyć tablicę tablic?
Pierwszy krok to policzyć elementy, a nie kolejki. Przy każdym zadaniu, które na kogoś czeka, warto zapisać, na kogo, od kiedy i które jest w ich kolejce. Samo to zmienia rozmowę na planowaniu, bo „czekamy na zespół B” zamienia się w „czekamy jedenaście dni i jesteśmy na piętnastym miejscu w kolejce”.
Drugi krok to pokazać zagnieżdżenie. Wspólna tablica zależności albo prosta lista „co czeka na kogo” między kilkoma zespołami pozwala zobaczyć, gdzie kolejka jest najdłuższa. Zwykle okazuje się, że jeden zespół jest wskaźnikiem w połowie tablic w firmie.
Trzeci krok to zmniejszyć liczbę poziomów. W programowaniu tablicę tablic często spłaszcza się do jednej, żeby dane leżały w jednym miejscu i dało się je przejść jedną pętlą. W organizacji oznacza to zespoły, które mogą dostarczyć zmianę bez czekania na innych, platformy z samoobsługą zamiast zgłoszeń albo zespół, z którym czasem pracujemy razem. Skelton i Pais w „Team Topologies” opisują właśnie takie układy: zespoły ułożone wzdłuż strumienia wartości, zespoły platformowe i współpracę na określony czas. Każdy usunięty poziom to jedna kolejka mniej, w której praca może utknąć.
Nie da się usunąć wszystkich zależności. Da się sprawić, żeby było je widać i żeby liczyć je tak, jak liczy się pracę, a nie jako jedną kartę „zablokowane”.
Bibliografia
- Stroustrup, B. (2013). The C++ Programming Language (4th ed.). Addison-Wesley.
- Kernighan, B. W., Ritchie, D. M. (1988). The C Programming Language (2nd ed.). Prentice Hall.
- Little, J. D. C. (1961). A Proof for the Queuing Formula: L = λW. Operations Research, 9(3), 383–387.
- Reinertsen, D. G. (2009). The Principles of Product Development Flow: Second Generation Lean Product Development. Celeritas Publishing.
- Modig, N., Åhlström, P. (2012). This is Lean: Resolving the Efficiency Paradox. Rheologica Publishing.
- Skelton, M., Pais, M. (2019). Team Topologies: Organizing Business and Technology Teams for Fast Flow. IT Revolution Press.
💬 Dołącz do dyskusji na LinkedIn → Komentuj i podziel się swoim podejściem
Tomasz Żelezny
Scrum Master · Agile Coach
Pomagam zespołom robić mniej rzeczy naraz i kończyć więcej. Piszę o przepływie pracy, decyzjach i o tym, gdzie znika wysiłek zespołów.
Twój zespół może więcej niż dowozi.
Zobacz, jak pomagam